

PostgreSQL Replication Lag: Darboğazı Adım Adım Teşhis Etme
Replica geriden geliyor. Sorun WAL üretiminde, gönderimde, aktarımda veya replay aşamasında mı? Salt okunur kontrollerle önce gecikmenin hangi aşamada biriktiğini bulun.
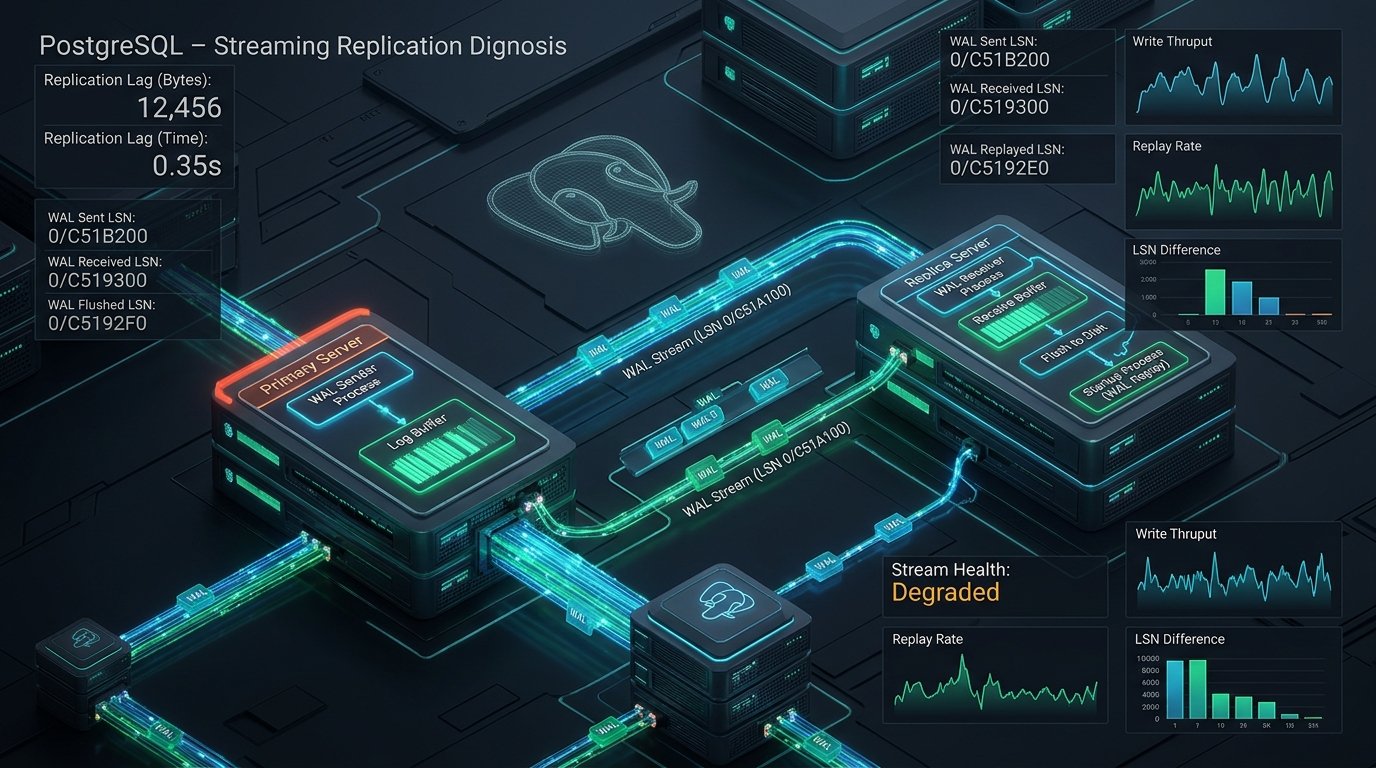
▸Kısa Açıklama
Replica geriden geliyor. Sorun WAL üretiminde, gönderimde, aktarımda veya replay aşamasında mı? Salt okunur kontrollerle önce gecikmenin hangi aşamada biriktiğini bulun.
Replication lag tek başına kök neden değildir. Kullanıcıların eski veri görmesine, raporların güncelliğini kaybetmesine veya kurtarma hazırlığının zayıflamasına eşlik edebilen bir belirtidir. İlk adım rastgele parametre değiştirmek değil, topolojiyi ve gecikmenin yerini belirlemektir.
Bir replica’nın primary’ye bağlı olması, aldığı değişiklikleri aynı hızda uyguladığı anlamına gelmez. Benzer şekilde, bir izleme ekranında yüksek bir “lag seconds” değeri görmek de tek başına replikasyonun durduğunu kanıtlamaz.
Doğru teşhis için üç soruyu birbirinden ayırın:
- 1Bağlantı var mı? Beklenen standby, doğru upstream sunucuya bağlı mı?
- 2WAL ilerliyor mu? Gönderilen, yazılan, kalıcılaştırılan ve uygulanan konumlar ilerliyor mu?
- 3Hizmet etkileniyor mu? Replica’nın sunduğu veri, kullanım amacı için yeterince güncel mi?
Bu rehber PostgreSQL fiziksel streaming replication ve doğrudan primary–standby bağlantısına odaklanır. Logical replication ayrı değerlendirilmelidir. Cascading yapılarda her bağlantı ayrıca incelenmelidir.
▸Önce Kavramları Ayırın: Birikim, Gecikme ve Veri Güncelliği
“Replication lag” ifadesi farklı ölçümleri anlatmak için kullanılabilir:
| Kavram | Yanıtladığı soru | Tek başına söylemediği |
|---|---|---|
| WAL konum farkı | İki aşama arasında kaç byte WAL var? | Kaç transaction geride olunduğu veya ne zaman yetişileceği |
write_lag, flush_lag, replay_lag | Yakın tarihli WAL’ın ilgili aşamaya ulaşması ve bunun primary’ye bildirilmesi ne kadar sürdü? | Mevcut birikimin ne kadar sürede kapanacağı |
| Son replay edilen transaction’ın yaşı | Son uygulanan transaction’ın primary üzerindeki zamanı ne kadar eski? | Primary’de yeni transaction olup olmadığı |
| Uygulama veri güncelliği | Kullanıcının ihtiyaç duyduğu değişiklik okuma yolunda görülebiliyor mu? | Darboğazın hangi teknik aşamada olduğu |
Bu ölçümler birbirinin alternatifi değil, tamamlayıcısıdır. Örneğin primary üzerinde yeni transaction oluşmuyorsa son replay zamanı eski kalabilir; replica buna rağmen mevcut WAL’ı tamamen uygulamış olabilir.
▸Önce Bağlamı Kaydedin
- •PostgreSQL ve izleme aracı sürümü.
- •Primary ile standby arasındaki bağlantı ve varsa ara replica.
- •Senkron/asenkron yapı, kasıtlı geciktirme politikası.
- •Replica’nın rolü: raporlama, okuma trafiği veya failover adayı.
- •Sorunun başladığı zaman, bakım ve toplu yükleme gibi eşzamanlı değişiklikler.
Bu listeyi olayın başında doldurmak önemlidir. Aynı teknik bulgu farklı topolojilerde farklı anlama gelebilir. Raporlama için kasıtlı geciktirilmiş bir replica ile düşük veri eskiliği hedefleyen okuma replica’sı aynı eşikle değerlendirilmemelidir.
Sorgular salt okunurdur. İstatistik alanlarının görünürlüğü ve fonksiyon erişimleri rolünüze ve servis sağlayıcınıza bağlıdır. Yetkili DBA’nın belirlediği en az yetkili izleme hesabını kullanın; yalnızca sorgu çalıştırmak için superuser vermeyin. Örnekler PostgreSQL 18 dokümantasyonuna göre hazırlanmıştır.
▸Aşama 1 — Hangi Sunucudasınız?
Primary ve standby üzerinde ayrı ayrı çalıştırın:
SELECT clock_timestamp() AS sampled_at,
       current_setting('server_version') AS server_version,
       pg_is_in_recovery() AS in_recovery;
Normal fiziksel standby üzerinde recovery durumu true olmalıdır. Beklenmeyen sonuçta önce rol veya topoloji değişikliğini kontrol edin.
Özellikle bağlantı havuzu, servis adresi veya failover sonrası güncellenen bir endpoint kullanıyorsanız sunucunun rolünü varsaymayın. “Replica adresine bağlandım” düşüncesi, sorgunun gerçekten standby üzerinde çalıştığının kanıtı değildir.
Bu aşamanın çıktısı: Ölçüm zamanı, PostgreSQL sürümü ve doğrulanmış sunucu rolü.
▸Aşama 2 — Primary Üzerindeki Bağlantıyı ve WAL Konumlarını Görün
Yalnızca primary üzerinde:
SELECT clock_timestamp() AS sampled_at,
       application_name,
       state,
       sync_state,
       sent_lsn,
       write_lsn,
       flush_lsn,
       replay_lsn,
       pg_wal_lsn_diff(pg_current_wal_lsn(), sent_lsn)
         AS current_to_sent_bytes,
       pg_wal_lsn_diff(sent_lsn, write_lsn)
         AS sent_to_write_bytes,
       pg_wal_lsn_diff(write_lsn, flush_lsn)
         AS write_to_flush_bytes,
       pg_wal_lsn_diff(flush_lsn, replay_lsn)
         AS flush_to_replay_bytes,
       write_lag,
       flush_lag,
       replay_lag
FROM pg_stat_replication;
LSN, WAL içindeki konumu ifade eder. Farklar byte cinsindedir; satır veya transaction sayısı değildir. Bu alanlar standby’dan bildirilen konumlara dayanır; anlık bir snapshot kesin kök neden kanıtı değildir. Lag süreleri de “replica kaç saniyede yetişir?” tahmini değildir. Boşta ve yetişmiş bir sistemde süre alanları NULL olabilir. NULL değerini otomatik olarak sıfır veya arıza diye sınıflandırmayın.
Önemli ayrıntı: pg_current_wal_lsn() primary’nin mevcut WAL write konumunu verir; WAL insert veya kalıcı depolamaya flush konumuyla aynı kavram değildir. Bu nedenle current_to_sent_bytes alanını, “üretilmiş bütün WAL’ın mutlak ve eksiksiz ölçüsü” olarak değil, sorguda seçilen write konumuyla gönderim konumu arasındaki fark olarak okuyun.
Ayrıca pg_stat_replication yalnızca doğrudan bağlı standby’ları gösterir. Primary üzerindeki sonuç kümesinde görünmeyen bir downstream replica, cascading topolojide bir ara standby’a bağlı olabilir.
Bulguları nasıl kullanmalısınız?
| Tekrarlanan gözlem | İnceleme yönü; kesin neden değildir |
|---|---|
| Beklenen replica satırı yok | Bağlantı, servis durumu, topoloji ve kimlik doğrulama |
| current_to_sent farkı büyüyor | WAL üretim hızı, sender kapasitesi ve geri basınç |
| sent_to_write farkı büyüyor | Ağ yolu, receiver kapasitesi ve standby yazma performansı |
| write_to_flush farkı büyüyor | Standby depolama gecikmesi |
| flush_to_replay farkı büyüyor | Replay ilerlemesi, kaynak rekabeti ve recovery beklemeleri |
Tek bir ölçüm yerine kısa bir zaman serisi alın. Üretim artışı ile tüketim yavaşlamasını aynı şey sanmayın. İstatistiklerin uzun bir transaction içindeki snapshot etkisini azaltmak için örnekleri ayrı autocommit sorguları olarak alın.
Zaman serisinde yalnızca farkın büyüklüğünü değil, yönünü de inceleyin:
- •Fark büyüyor: İlgili aşama, gözlem aralığında gelen WAL’a yetişemiyor olabilir.
- •Fark küçülüyor: Replica birikimi kapatıyor olabilir; henüz tamamen toparlanmış sayılmaz.
- •Fark sabit: Sabit bir gecikme, dengelenmiş ama kabul edilmeyen bir birikim veya ilerlemeyen iki konum söz konusu olabilir. LSN’lerin kendisine de bakın.
- •Satır kayboluyor: Değerin sıfıra indiğini değil, bağlantının veya gözlemin kaybolduğunu değerlendirin.
state alanındaki streaming değeri de tek başına “hiç gecikme yok” anlamına gelmez. Bağlantı durumu ile WAL açığını birlikte okuyun.
▸Aşama 3 — Standby Üzerindeki İlerlemeyi Kontrol Edin
Yalnızca standby üzerinde:
SELECT clock_timestamp() AS sampled_at,
       pg_last_wal_receive_lsn() AS received_lsn,
       pg_last_wal_replay_lsn() AS replayed_lsn,
       pg_wal_lsn_diff(pg_last_wal_receive_lsn(),
                    pg_last_wal_replay_lsn())
         AS received_to_replayed_bytes,
       pg_is_wal_replay_paused() AS replay_paused,
       pg_last_xact_replay_timestamp() AS last_replayed_xact_at;
Son replay edilen transaction’ın zamanı, güncel replication lag ile aynı değildir: yeni transaction yoksa bu tarih eski kalabilir. Receive–replay farkı da kaynaktaki toplam açığı göstermez. Arşivden recovery gibi durumlarda ayrıca yorumlanmalıdır.
Replay paused görülürse duraklatmanın planlı olup olmadığını öğrenin; otomatik resume uygulamayın. Benzer şekilde kasıtlı geciktirilmiş replica’yı normal replica eşiğiyle değerlendirmeyin.
Duraklatma konusunda teknik ayrıntı: pg_is_wal_replay_paused() duraklatma isteği bulunup bulunmadığını bildirir. İsteğin gerçekten uygulanıp uygulanmadığını ayırmak gerektiğinde PostgreSQL’in belgelediği pg_get_wal_replay_pause_state() fonksiyonunun döndürdüğü durum incelenmelidir. Duraklatma isteği ile recovery’nin fiilen durmuş olması aynı anlama gelmez.
Bu sorgudaki received_lsn de genel bir ağ alım sayacı değildir: kullanılan fonksiyon, streaming replication yoluyla alınmış ve diske senkronize edilmiş son WAL konumunu döndürür. Streaming henüz başlamadıysa veya devre dışıysa NULL olabilir.
Primary ve standby ölçümleri aynı anda alınmadığından, iki taraftan gelen değerleri karşılaştırırken örnekleme zamanlarını kaydedin. Farklı anlara ait ölçümleri tek bir atomik görüntü gibi değerlendirmeyin.
▸Aşama 4 — Hipotezi İkinci Kanıtla Doğrulayın
- •Ağ şüphesinde: paket kaybı, throughput ve bağlantı kesintilerini inceleyin.
- •Depolama şüphesinde: standby disk gecikmesi, throughput ve boş alanı karşılaştırın.
- •Replay şüphesinde: PostgreSQL logları, recovery çatışmaları ve eşzamanlı raporlama yükünü inceleyin.
- •WAL üretim artışında: toplu yükleme ve uygulama değişikliklerinin zamanını karşılaştırın.
- •Slot kullanılan yapılarda: retained WAL ve primary disk riskini ayrıca izleyin.
İkinci kanıtın amacı, ilk hipotezi yalnızca desteklemek değil, yanlış olabileceğini de sınamaktır.
| İlk hipotez | Destekleyebilecek ek gözlem | Kontrol edilmesi gereken alternatif |
|---|---|---|
| Ağ darboğazı | Aynı aralıkta aktarım sorunları ve bağlantı kesintileri | Standby’ın WAL yazımına yetişememesi |
| Standby depolaması yavaş | Artan disk gecikmesi ve flush birikimi | Kaynak rekabeti veya altyapı sınırı |
| Raporlama yükü replay’i etkiliyor | Recovery çatışmaları, ilgili loglar ve yük değişimi | Disk/CPU sorununun hem sorguları hem replay’i etkilemesi |
| Ani WAL üretimi kapasiteyi aştı | Yazma işiyle aynı zamanda başlayan birikim | Aynı anda replica kapasitesinin düşmesi |
Bir raporlama sorgusunun uzun sürmesi, onun kesin olarak replay’i engellediğini göstermez. Kaynak rekabeti ile recovery çatışmasını ayrı değerlendirin. Benzer şekilde çatışma nedeniyle iptal edilen sorguların sayısı, bekleme süresinin doğrudan ölçüsü değildir.
Slot silme, WAL dosyası silme, oturum sonlandırma veya failover bu teşhis sorgularının doğal devamı değildir; her biri ayrı karar ve yetkilendirme gerektirir.
▸Örnek Yorum — Ölçülmüş Vaka Değildir
Birden fazla örnekte gönderim ve yazma farklarının küçük, flush–replay farkının büyüyen olduğunu varsayalım. Aynı anda standby disk gecikmesinin artması replay/depolama hattına odaklanmak için gerekçe oluşturur. Bu bulgu tek başına “sorun kesin disktir” sonucunu vermez.
İncelemeyi şu şekilde ilerletin:
- 1Ölçümlerin güncel olduğunu ve aynı replica’yı temsil ettiğini doğrulayın.
- 2Replay konumunun tamamen durmuş mu, yoksa yavaş ilerliyor mu olduğunu belirleyin.
- 3Planlı duraklatma ve kasıtlı geciktirme olasılığını dışlayın.
- 4Disk, CPU, raporlama yükü ve recovery loglarını aynı zaman aralığında karşılaştırın.
- 5Yetkili ve geri alınabilir bir müdahale yapılırsa öncesi/sonrası eğilimini kaydedin.
Müdahale sonrasında birikimin azalması, seçilen aksiyonun yararlı olduğunu gösterebilir. Ancak aynı anda bir toplu yüklemenin bitmesi gibi başka değişiklikler olduysa, bu sonuç tek başına kök nedenin doğrulandığı anlamına gelmez.
▸Sık Yapılan Teşhis Hataları
- •Son transaction’ın yaşını gerçek lag kabul etmek: Boşta sistemlerde yanıltıcı olabilir.
- •NULL değerleri sıfıra çevirmek: Bilinmeyen durumları sağlıklı gösterebilir.
- •Yalnızca standby’daki receive–replay farkına bakmak: Standby’a henüz ulaşmamış WAL’ı görünmez bırakabilir.
- •Bağlı replica sayısını beklenen replica sayısı sanmak: Kaybolan replica envanter olmadan fark edilmeyebilir.
- •İlk çözüm olarak restart yapmak: Kanıt toplamadan müdahale etmeye ve gereksiz kesintiye yol açabilir.
- •Replay açığını doğrudan veri kaybı saymak: Alınmış ve kalıcılaştırılmış ama henüz uygulanmamış WAL ile replica’ya hiç ulaşmamış WAL’ı karıştırır.
▸Teşhis Tamamlandığında Elinizde Ne Olmalı?
İyi bir teşhis kaydı yalnızca “lag vardı” demez. Şunları içerir:
- •Etkilenen replica ve doğrulanmış rolü.
- •Sorunun gözlendiği zaman aralığı.
- •Birikimin oluştuğu düşünülen aşama.
- •Bu hipotezi destekleyen ve zayıflatan kanıtlar.
- •Primary ve standby üzerindeki hizmet/kapasite etkisi.
- •Yapılan değişiklikler ve toparlanma gözlemleri.
- •Doğrulanmış kök neden veya açık kalan inceleme maddesi.
▸Kaynaklar
- •PostgreSQL 18 — Monitoring Statistics
- •PostgreSQL 18 — System Administration Functions
- •PostgreSQL 18 — Log-Shipping Standby Servers / Streaming Replication
▸Replikasyon Sağlığı Ortak Seri Bağlantıları
- •İzleme araçları değerlendirme kontrol listesi için dataxtools: Replication Lag İzleme: Araçlarda Hangi Özellikleri Aramalısınız?
- •Olay eskalasyonu ve nöbetçi runbook'u için dataopsphere: Replication Lag Alarmından Müdahaleye: Eskalasyon Runbook’u
Replikasyon Gecikmesi & Mimari Deneyiminizi Paylaşın
Altyapınızdaki gerçek PostgreSQL replikasyon topolojisini, karşılaştığınız darboğazları (WAL, ağ, disk, replay kilitleri) ve izleme yaklaşımlarını paylaşarak sektör benchmark'larına katkıda bulunun.
Replication Lag İzleme: Araçlarda Hangi Özellikleri Aramalısınız?
postgres_exporter + Prometheus + Grafana ve Percona PMM 3: Ölçüm güvenilirliği, boşta sistem davranışı ve pilot test planı.
Replication Lag Alarmından Müdahaleye: Eskalasyon Runbook’u
Nöbetçi SRE/DBA için 7 adımlı müdahale protokolü, önceden doldurulacak hizmet kartı, iş etkisi matrisi ve postmortem aksiyonları.