

PostgreSQL Shared Buffers ve Linux Page Cache Etkileşimi: Bellek Yönetiminin Görünmeyen Katmanı
PostgreSQL Shared Buffers ve Linux Page Cache etkileşimi, buffered I/O yolu, double caching mekanizması, cache hit ratio yanılgısı ve bellek optimizasyonu rehberi.
PostgreSQL Shared Buffers ve Linux Page Cache Etkileşimi: Bellek Yönetiminin Görünmeyen Katmanı
Kategori: PostgreSQL → Performance Tuning → Memory Management Teknik seviye: Intermediate / Advanced Okuma süresi: 18–22 dakika
1. Giriş: PostgreSQL Verileri Gerçekte Nerede Önbelleğe Alır?
PostgreSQL performans optimizasyonunda en sık tartışılan parametrelerden biri shared_buffers değeridir.
Özellikle yeni bir PostgreSQL sunucusu yapılandırılırken genellikle şu öneriyle karşılaşılır:
Bu öneri çoğu sistem için makul bir başlangıç noktasıdır. Ancak PostgreSQL'in bellek mimarisini anlamadan yalnızca bu parametreyi değiştirmek, beklenen performans kazanımını sağlamayabilir.
Çünkü PostgreSQL veritabanı sayfalarını önbelleğe almak için tek bir mekanizma kullanmaz.
Standart Linux dosya sistemi I/O yolunda iki önemli önbellek katmanı bulunur:
- 1PostgreSQL Shared Buffers: Veritabanı motorunun doğrudan yönettiği paylaşımlı bellek alanı.
- 2Linux Page Cache: İşletim sistemi çekirdeğinin dosya içeriklerini bellekte tutmak için kullandığı önbellek mekanizması.
Bu iki katman birbirinden bağımsız yönetilmesine rağmen veritabanı performansını birlikte etkiler.
Örneğin PostgreSQL tarafından bir veri bloğunun Shared Buffers içerisinde bulunamaması, o bloğun mutlaka fiziksel diskten okunacağı anlamına gelmez.
İlgili blok Linux Page Cache içerisinde mevcut olabilir.
Bu ayrım, PostgreSQL performans analizinin en kritik noktalarından biridir.
Bu makalede şu soruların yanıtlarını inceleyeceğiz:
- •PostgreSQL Shared Buffers ve Linux Page Cache nasıl çalışır?
- •Bir SQL sorgusu çalıştırıldığında veri hangi katmanlardan geçer?
- •Aynı veri iki farklı bellek alanında tutulabilir mi?
- •Shared Buffers değerini artırmak her zaman performansı iyileştirir mi?
- •PostgreSQL cache hit ratio neden tek başına yeterli değildir?
- •Linux Page Cache kullanımını nasıl izleyebiliriz?
- •Gerçek bir sistemde ideal bellek dağılımını nasıl belirleyebiliriz?
2. PostgreSQL Bellek Mimarisine Genel Bakış
PostgreSQL'in bellek kullanımı yalnızca shared_buffers parametresinden ibaret değildir.
Veritabanı sunucusunun toplam bellek tüketimi farklı bileşenlerden oluşur.
| Bellek bileşeni | Görevi |
|---|---|
| Shared Buffers | Veritabanı veri bloklarını önbelleğe almak |
| WAL Buffers | WAL kayıtlarını geçici olarak bellekte tutmak |
| Work Memory | Sort, hash join ve benzeri işlemlere bellek sağlamak |
| Maintenance Work Memory | VACUUM, CREATE INDEX gibi bakım işlemlerine bellek sağlamak |
| Backend Memory | Bağlantıların ve sorgu yürütme süreçlerinin özel bellek alanları |
| Linux Page Cache | Dosya sistemi üzerinden erişilen verileri önbelleğe almak |
Burada önemli bir ayrım bulunmaktadır.
Shared Buffers, PostgreSQL tarafından yönetilen paylaşımlı bellek alanıdır.
Linux Page Cache ise PostgreSQL'e özel değildir. İşletim sistemi üzerinde çalışan diğer uygulamalar da aynı mekanizmadan yararlanabilir.
Dolayısıyla PostgreSQL için ayrılan bellek miktarı ile işletim sisteminin kullanabileceği bellek miktarı arasında bir denge kurulmalıdır.
▸2.1 Shared Buffers nedir?
Shared Buffers, PostgreSQL'in tablo ve indeks sayfalarını bellekte tuttuğu ortak buffer havuzudur.
PostgreSQL'in standart veri bloğu boyutu genellikle 8 KB'dir.
Örneğin:
shared_buffers = 8GBBu konfigürasyonda 8 KB blok boyutu kullanılıyorsa yaklaşık 1.048.576 veri bloğu için buffer kapasitesi ayrılmış olur.
Shared Buffers içerisindeki bir sayfa, farklı PostgreSQL backend süreçleri tarafından kullanılabilir.
Bu sayede aynı veri bloğunun her sorgu için yeniden dosya sisteminden okunması gerekmez.
PostgreSQL buffer yönetiminde kullanım geçmişini dikkate alan clock-sweep temelli bir değiştirme mekanizması kullanır.
Ayrıca bazı büyük tarama ve bakım işlemleri, normal çalışma kümesinin önbellekten çıkarılmasını azaltmak amacıyla özel buffer access strategy mekanizmalarından yararlanır.
▸2.2 Linux Page Cache nedir?
Linux Page Cache, dosyalardan okunan verilerin fiziksel bellekte saklanmasını sağlayan kernel mekanizmasıdır.
Bir uygulama dosyadan veri okumak istediğinde, standart buffered I/O yolunda Linux önce ilgili verinin Page Cache içerisinde bulunup bulunmadığını değerlendirir.
Veri önbellekte bulunuyorsa okuma fiziksel depolama aygıtına erişmeden karşılanabilir.
Bulunmuyorsa gerekli dosya sayfaları depolama katmanından okunur ve uygun koşullarda Page Cache içerisine yerleştirilir.
Linux, bellek baskısı oluştuğunda temiz dosya önbelleği sayfalarını geri kazanabilir. Kirli sayfaların ise yeniden kullanılmadan önce uygun biçimde yazılması gerekebilir.
Bu nedenle Linux tarafından cache amacıyla kullanılan belleğin tamamını boşa harcanmış veya kullanılamaz bellek olarak değerlendirmek yanlıştır.
3. Bir PostgreSQL Sorgusu Çalıştırıldığında Ne Olur?
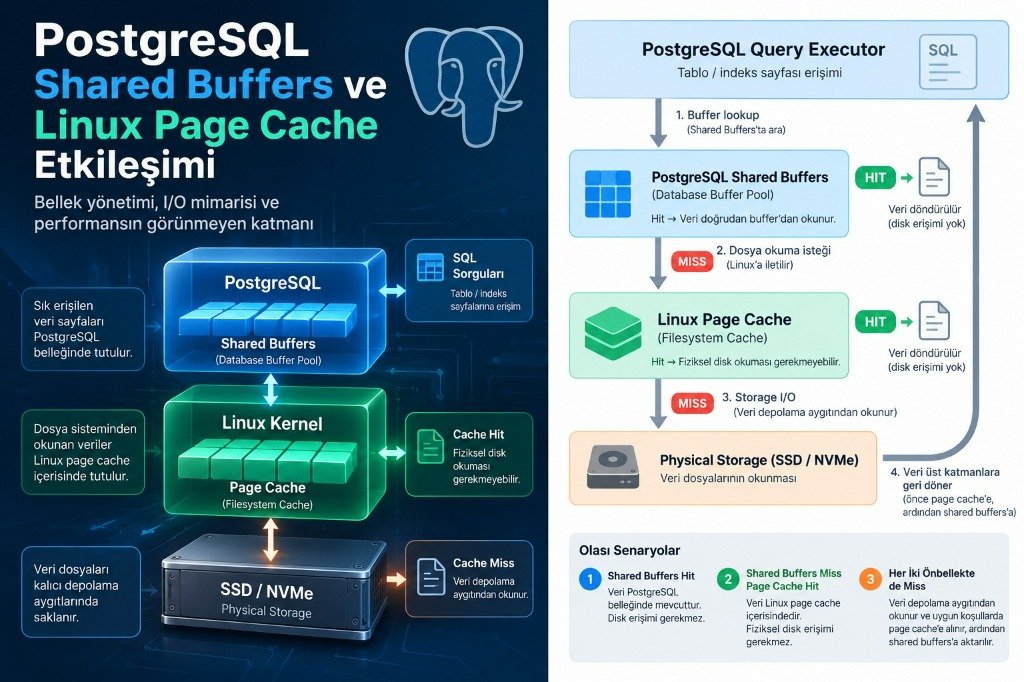
Konuyu somutlaştırmak için aşağıdaki sorguyu düşünelim:
SELECT *
FROM orders
WHERE order_id = 10001;
İlgili tablo veya indeks sayfasının PostgreSQL tarafından okunması gerektiğini varsayalım.
▸Senaryo A: Veri Shared Buffers içerisinde mevcut
PostgreSQL gerekli bloğu Shared Buffers içerisinde bulur.
Bu durumda veri dosyasından yeni bir okuma yapılmasına gerek kalmaz.
Bu olay PostgreSQL istatistiklerinde bir buffer hit olarak görülebilir.
▸Senaryo B: Shared Buffers miss, Linux Page Cache hit
İlgili blok Shared Buffers içerisinde bulunmaz.
PostgreSQL veri dosyası için okuma isteği oluşturur.
Ancak gerekli dosya sayfaları Linux Page Cache içerisinde zaten bulunmaktadır.
Bu durumda okuma isteği fiziksel depolama aygıtından veri çekilmeden karşılanabilir.
PostgreSQL açısından bir buffer read gerçekleşmiş olmasına rağmen fiziksel disk okuması gerçekleşmeyebilir.
▸Senaryo C: Her iki önbellekte de veri bulunmuyor
İlgili veri Shared Buffers içerisinde mevcut değildir.
Linux Page Cache de gerekli dosya sayfalarını içermemektedir.
Bu durumda standart dosya sistemi I/O yolunda veri depolama aygıtından okunur.
Veri, Linux'un önbellekleme davranışına bağlı olarak Page Cache içerisine alınabilir ve PostgreSQL'in ilgili buffer'ına aktarılır.
Bu üç senaryonun performans etkileri farklıdır.
Özellikle ikinci senaryo, PostgreSQL performans istatistiklerinin yanlış yorumlanmasına neden olabilir.
Önemli: Bu akış PostgreSQL'in olağan buffered filesystem I/O davranışını açıklamaktadır. Direct I/O, özel I/O yolları ve bazı depolama yapılandırmaları farklı davranabilir.
4. Double Caching: Aynı Veri Bellekte İki Kez Tutulabilir mi?
Evet.
PostgreSQL'in geleneksel buffered I/O mimarisinde aynı veri sayfasının hem Shared Buffers hem de Linux Page Cache içerisinde bulunması mümkündür.
Bu durum genellikle *double caching* olarak adlandırılır.
Örneğin 8 KB büyüklüğündeki bir tablo bloğu:
- •PostgreSQL Shared Buffers içerisinde bir kopyaya,
- •Linux Page Cache içerisinde başka bir kopyaya
sahip olabilir.
Bu durum her blok için sürekli iki kopya bulunduğu anlamına gelmez.
Önbelleklerin içerikleri, erişim geçmişleri ve bellek baskısı altında verdikleri kararlar farklı olabilir.
▸4.1 Double caching her zaman kötü müdür?
Hayır.
İlk bakışta aynı verinin iki kez saklanması bellek israfı gibi görünebilir.
Ancak iki katman farklı görevler üstlenir.
Shared Buffers, PostgreSQL'e veritabanı sayfaları üzerinde doğrudan kontrol sağlar.
Linux Page Cache ise dosya sistemi seviyesinde önbellekleme, read-ahead ve kernel bellek geri kazanımı gibi işlevleri yerine getirir.
Önemli olan, iki önbelleğin toplam bellek tüketiminin iş yükü açısından dengeli olmasıdır.
▸4.2 Shared Buffers çok büyük olursa ne olur?
Shared Buffers büyüdükçe PostgreSQL daha fazla veritabanı sayfasını kendi belleğinde tutabilir.
Ancak bu alan için ayrılan fiziksel bellek, Linux'un Page Cache ve diğer bellek ihtiyaçları için kullanabileceği alanı azaltabilir.
Bunun olası sonuçları şunlardır:
- •İşletim sistemi dosya önbelleği kapasitesinin daralması
- •Diğer PostgreSQL bellek tüketimleri için alanın azalması
- •Bellek baskısı ve swap riskinin artması
- •Checkpoint ve writeback davranışlarının değişmesi
- •Bazı iş yüklerinde performansın iyileşmek yerine kötüleşmesi
Dolayısıyla en büyük Shared Buffers değeri, her zaman en iyi değer değildir.
5. Shared Buffers İçin %25 Kuralı Nereden Geliyor?
PostgreSQL resmi dokümantasyonu, yeterli belleğe sahip ve veritabanına ayrılmış sunucular için fiziksel RAM'in yaklaşık %25'ini başlangıç noktası olarak önermektedir.
Bunun temel nedenlerinden biri PostgreSQL'in işletim sistemi önbelleğinden de yararlanmasıdır.
Dokümantasyon ayrıca bazı iş yüklerinde daha büyük Shared Buffers değerlerinin yararlı olabileceğini, ancak RAM'in %40'ından fazlasını ayırmanın genellikle daha iyi sonuç vermeyeceğini belirtir.
Bu değerler kesin performans sınırları değildir.
İdeal konfigürasyon; iş yüküne, bellek kapasitesine, bağlantı sayısına, depolama performansına ve PostgreSQL sürümüne bağlıdır.
▸5.1 Örnek: 64 GB RAM bulunan bir sunucu
Aşağıdaki tablo bir konfigürasyon önerisi değil, farklı Shared Buffers değerlerinin bellek bütçesini nasıl değiştirdiğini gösteren örnektir.
| Shared Buffers | RAM oranı | Diğer kullanımlar için kalan teorik RAM |
|---|---|---|
| 8 GB | %12,5 | 56 GB |
| 16 GB | %25 | 48 GB |
| 24 GB | %37,5 | 40 GB |
| 32 GB | %50 | 32 GB |
Kalan RAM'in tamamı Linux Page Cache için kullanılmaz.
İşletim sistemi, PostgreSQL backend süreçleri, sorgu çalışma belleği, bakım işlemleri ve diğer uygulamalar da bu alanı tüketir.
Bu nedenle gerçek kapasite planlaması yapılırken toplam bellek bütçesi değerlendirilmelidir.
6. PostgreSQL Cache Hit Ratio Neden Yanıltıcı Olabilir?
PostgreSQL yöneticilerinin sık kullandığı performans göstergelerinden biri cache hit ratio değeridir.
Aşağıdaki sorgu veritabanı seviyesinde buffer hit oranını hesaplar:
SELECT
    datname,
    blks_hit,
    blks_read,
    ROUND(
        100.0 * blks_hit /
        NULLIF(blks_hit + blks_read, 0),
        2
    ) AS cache_hit_ratio
FROM pg_stat_database
WHERE datname IS NOT NULL;
Örneğin aşağıdaki sonuç elde edilsin:
| Database | Cache hit ratio |
|---|---|
| production | %99,2 |
| reporting | %87,4 |
| analytics | %76,8 |
İlk bakışta production veritabanının çok iyi, analytics veritabanının ise kötü performans gösterdiği düşünülebilir.
Ancak bu çıkarım doğru olmayabilir.
▸6.1 PostgreSQL cache hit oranı neyi ölçer?
Bu oran, PostgreSQL tarafından erişilen blokların ne kadarının Shared Buffers içerisinde bulunduğunu gösterir.
Linux Page Cache hit oranını doğrudan ölçmez.
Örneğin analytics veritabanında Shared Buffers hit oranı %76,8 olsa bile kalan okumaların önemli bir kısmı Linux Page Cache üzerinden karşılanıyor olabilir.
Bu durumda gerçek fiziksel disk I/O miktarı beklenenden düşük olabilir.
Ayrıca büyük sequential scan işlemleri yapan analitik sistemlerde buffer hit oranının OLTP sistemlerine göre daha düşük olması doğal olabilir.
Sonuç: Cache hit ratio bir teşhis göstergesidir; tek başına performans hedefi değildir.
▸6.2 EXPLAIN ile buffer kullanımını incelemek
EXPLAIN (ANALYZE, BUFFERS)
SELECT *
FROM orders
WHERE order_date >= DATE '2026-01-01';
Örnek olarak şu tür bir çıktı görülebilir:
Buffers: shared hit=8500 read=1500Burada:
- •
shared hit=8500: Shared Buffers içerisinden karşılanan blok erişimleri - •
read=1500: Shared Buffers içerisinde bulunmayıp okuma gerektiren blok erişimleri
anlamına gelir.
Ancak read=1500, mutlaka 1500 fiziksel disk okuması gerçekleştiği anlamına gelmez.
Bu okumaların bazıları Linux Page Cache tarafından karşılanmış olabilir.
7. PostgreSQL ve Linux Önbelleklerini Birlikte İzlemek
Sağlıklı performans analizi için PostgreSQL ve işletim sistemi metrikleri birlikte incelenmelidir.
▸7.1 PostgreSQL konfigürasyonunu kontrol etmek
SHOW shared_buffers;
SHOW effective_cache_size;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW track_io_timing;
Bu parametrelerden effective_cache_size özellikle önemlidir.
Ancak sık yapılan bir hata bulunmaktadır:
effective_cache_size gerçek bir bellek tahsisi değildir.
PostgreSQL sorgu planlayıcısının, sorgunun kullanabileceği önbellek kapasitesi hakkında yaptığı varsayımı temsil eder.
Bu değer Shared Buffers ve işletim sistemi dosya önbelleği kapasitesi dikkate alınarak tahmin edilebilir.
Yanlış yapılandırılması, sorgu planlayıcısının index scan ve sequential scan gibi erişim yöntemleri arasındaki maliyet değerlendirmesini etkileyebilir.
▸7.2 Linux bellek kullanımını incelemek
Linux üzerinde:
free -hveya:
cat /proc/meminfokomutları kullanılabilir.
Özellikle şu alanlar incelenmelidir:
| Metrik | Açıklama |
|---|---|
| MemAvailable | Yeni uygulamalar için swap olmadan kullanılabilir tahmini bellek |
| Cached | Dosya önbelleğiyle ilişkili bellek; bazı shmem kullanımlarını da içerir |
| Buffers | Kernel buffer kullanımı |
| Dirty | Henüz kalıcı depolamaya yazılmamış değiştirilmiş bellek |
| Writeback | Yazma işlemi devam eden bellek |
| SwapFree | Kullanılabilir swap kapasitesi |
Burada dikkat edilmesi gereken önemli nokta, Cached değerinin PostgreSQL'e özel olmamasıdır.
Ayrıca bu alan tek başına Linux Page Cache'in gerçek hit oranını göstermez.
▸7.3 vmstat ile bellek baskısını gözlemlemek
vmstat 1Özellikle şu alanlara dikkat edilmelidir:
- •
si: Swap üzerinden belleğe alınan veri - •
so: Bellekten swap alanına yazılan veri - •
wa: I/O bekleme ile ilişkili CPU zamanı - •
bivebo: Blok aygıtı I/O göstergeleri
Sürekli swap aktivitesi, yüksek bellek baskısı ve artan sorgu gecikmeleri birlikte görülüyorsa bellek dağılımının yeniden değerlendirilmesi gerekebilir.
Ancak tek bir vmstat alanı üzerinden kesin teşhis yapılmamalıdır.
▸7.4 PostgreSQL 16 ve üzeri sürümlerde pg_stat_io
PostgreSQL 16 ile gelen pg_stat_io görünümü, I/O davranışının daha ayrıntılı incelenmesine olanak sağlar.
SELECT
    backend_type,
    object,
    context,
    reads,
    hits,
    evictions,
    writes,
    fsyncs
FROM pg_stat_io
WHERE object = 'relation'
ORDER BY reads DESC NULLS LAST;
Bu görünüm sayesinde backend türleri ve I/O bağlamları karşılaştırılabilir.
Örneğin yüksek eviction sayıları Shared Buffers kapasitesinin veya buffer kullanım stratejisinin incelenmesi gerektiğini gösterebilir.
Bununla birlikte pg_stat_io da Linux Page Cache hit ve miss sayılarını doğrudan ayırmaz.
8. Gerçek Hayat Senaryosu: Shared Buffers Artırıldığı Halde Performans Neden Kötüleşti?
Aşağıdaki senaryo, bellek yönetimi açısından sık karşılaşılabilecek bir durumu açıklamak amacıyla hazırlanmış temsili bir örnektir. Gerçek bir üretim ortamından alınmış benchmark sonucu değildir.
▸Sistem özellikleri
- •İşletim sistemi: Linux
- •PostgreSQL: 16
- •Fiziksel RAM: 64 GB
- •Depolama: NVMe SSD
- •İş yükü: Karma OLTP ve raporlama
- •Veritabanı boyutu: 500 GB
Başlangıç konfigürasyonu:
shared_buffers = 16GB
effective_cache_size = 44GB
Performansı artırmak amacıyla Shared Buffers değeri 32 GB'a yükseltiliyor.
shared_buffers = 32GBBeklenti, daha fazla verinin PostgreSQL belleğinde tutulması ve sorguların hızlanmasıdır.
Ancak test sırasında bazı raporlama sorgularının daha yavaş çalıştığı gözlemleniyor.
▸Olası neden
Shared Buffers için ayrılan bellek artırıldığında işletim sistemi dosya önbelleği ve diğer bellek tüketicileri için daha az alan kalmış olabilir.
Bu durumda Shared Buffers içerisine sığmayan büyük veri kümelerinin yeniden okunması daha pahalı hale gelebilir.
Aynı zamanda sorgu çalışma belleği, bağlantı sayısı ve bellek baskısı da performansı etkileyebilir.
Dolayısıyla gözlemlenen yavaşlamanın yalnızca Page Cache kapasitesindeki azalmadan kaynaklandığı varsayılmamalıdır.
▸Nasıl doğrulanır?
Değişiklik öncesi ve sonrasında şu metrikler karşılaştırılmalıdır:
- 1Sorgu gecikmeleri ve p95/p99 değerleri
- 2PostgreSQL buffer hit/read oranları
- 3
pg_stat_iookuma, yazma ve eviction değişimleri - 4Depolama aygıtının gerçek I/O miktarı ve gecikmeleri
- 5Linux bellek baskısı ve swap aktivitesi
- 6Checkpoint ve writeback davranışı
Ölçümler benzer yük altında, yeterli süre boyunca ve mümkünse birden fazla tekrar ile gerçekleştirilmelidir.
9. Shared Buffers Optimizasyonu İçin Pratik Yaklaşım
Shared Buffers optimizasyonu yalnızca toplam RAM miktarına göre yapılmamalıdır.
▸Aşama 1: İş yükünü sınıflandırın
Öncelikle sistemin karakteristiği belirlenmelidir.
OLTP sistemleri: Sık erişilen indeks ve veri sayfaları nedeniyle Shared Buffers kullanımından önemli ölçüde yararlanabilir.
Analitik sistemler: Büyük sequential scan işlemleri, buffer replacement davranışı ve işletim sistemi önbelleği daha önemli hale gelebilir.
Karma sistemler: Her iki iş yükünün ihtiyaçları birlikte değerlendirilmelidir.
▸Aşama 2: Bellek bütçesini hesaplayın
Toplam fiziksel RAM üzerinden şu tüketimleri değerlendirin:
- •Shared Buffers
- •Backend ve bağlantı belleği
- •
work_memkullanan eşzamanlı sorgu işlemleri - •Maintenance ve autovacuum işlemleri
- •WAL ve diğer paylaşımlı bellek alanları
- •Linux kernel ve Page Cache
- •Diğer servisler
Özellikle work_mem değerinin toplam sistem için tek bir üst sınır olmadığını unutmayın.
Bir sorgu birden fazla sort veya hash işlemi çalıştırabilir. Eşzamanlı sorguların toplam bellek tüketimi önemli ölçüde artabilir.
▸Aşama 3: Başlangıç konfigürasyonu oluşturun
Örneğin 64 GB RAM bulunan, PostgreSQL'e ayrılmış bir sunucuda:
shared_buffers = 16GBmakul bir başlangıç olabilir.
Ancak bu değerin üretim için ideal olduğu, yalnızca RAM miktarına bakılarak söylenemez.
▸Aşama 4: Ölçün ve karşılaştırın
Farklı Shared Buffers değerlerini kontrollü testlerle değerlendirin.
Örneğin:
- •8 GB
- •16 GB
- •24 GB
Her testte aynı sorgu karışımını, benzer eşzamanlılık düzeyini ve mümkün olduğunca karşılaştırılabilir cache durumlarını kullanın.
shared_buffers değişikliğinin PostgreSQL yeniden başlatması gerektirdiğini unutmayın.
Yeniden başlatma sonrasında önbelleklerin ısınma süreci de test sonuçlarını etkileyebilir.
▸Aşama 5: Sadece cache hit ratio değil, kullanıcı deneyimini ölçün
En iyi konfigürasyon her zaman en yüksek cache hit ratio değerini sağlayan konfigürasyon değildir.
Asıl hedef:
- •Daha düşük sorgu gecikmesi
- •Daha yüksek sürdürülebilir throughput
- •Daha istikrarlı p95/p99 yanıt süreleri
- •Kabul edilebilir I/O yükü
- •Düşük bellek baskısı
- •Güvenilir checkpoint davranışı
olmalıdır.
10. Sık Yapılan Hatalar
▸Hata 1: Shared Buffers değerini mümkün olduğunca büyütmek
Büyük Shared Buffers her iş yükü için daha yüksek performans anlamına gelmez.
▸Hata 2: PostgreSQL buffer read değerini fiziksel disk okuması kabul etmek
PostgreSQL'in bir dosya okuması gerçekleştirmesi, Linux'un fiziksel depolama aygıtından veri okuduğunu kanıtlamaz.
▸Hata 3: Linux cache kullanımını gereksiz bellek tüketimi olarak değerlendirmek
Linux Page Cache normal ve yararlı bir bellek kullanım mekanizmasıdır.
▸Hata 4: effective_cache_size parametresini ayrılan bellek olarak yorumlamak
Bu parametre bellek ayırmaz; sorgu planlayıcısının maliyet tahminlerini etkiler.
▸Hata 5: Üretim ortamında test amacıyla Page Cache temizlemek
Aşağıdaki gibi komutlar:
sync
echo 3 | sudo tee /proc/sys/vm/drop_caches
üretim ortamlarında performans düşüşlerine ve ciddi I/O artışlarına neden olabilir.
Bu yaklaşım normal performans optimizasyonu yöntemi olarak kullanılmamalıdır. Kontrollü laboratuvar testleri dışında önerilmez.
▸Hata 6: Checkpoint davranışını göz ardı etmek
Büyük Shared Buffers konfigürasyonları dirty buffer yönetimini ve checkpoint süreçlerini etkileyebilir.
Bu nedenle max_wal_size, checkpoint sıklığı ve ilgili writeback metrikleri birlikte incelenmelidir.
11. DBA İçin Hızlı Teşhis Kontrol Listesi
PostgreSQL üzerinde bellek veya I/O performans problemi yaşandığında aşağıdaki soruların yanıtlanması yararlı olacaktır.
- Shared Buffers değeri toplam RAM ve iş yükü için uygun mu?
- PostgreSQL cache hit oranı zaman içinde nasıl değişiyor?
pg_stat_ioüzerinde yüksek read veya eviction aktivitesi var mı?- Linux
MemAvailabledeğeri sürekli düşük mü? - Swap aktivitesi ve bellek baskısı gözlemleniyor mu?
- Gerçek disk I/O miktarı ve latency değerleri ne durumda?
- Checkpoint sırasında I/O veya latency artışı oluşuyor mu?
- Büyük sequential scan işlemleri çalışma kümesini etkiliyor mu?
effective_cache_sizegerçekçi bir varsayıma dayanıyor mu?- Sorun konfigürasyondan mı, sorgu planından mı, yoksa erişim deseninden mi kaynaklanıyor?
Bu sorular birlikte değerlendirildiğinde, yalnızca Shared Buffers değerine odaklanan optimizasyonlardan daha güvenilir sonuçlar elde edilebilir.
12. Sonuç: PostgreSQL Bellek Optimizasyonu İki Katmanlı Düşünülmelidir
PostgreSQL performansını anlamak için yalnızca veritabanı motorunun kendi bellek yönetimini incelemek yeterli değildir.
Linux işletim sisteminin Page Cache davranışı da aynı derecede önemlidir.
Bu makaleden çıkarılması gereken temel sonuçlar şunlardır:
Birincisi: PostgreSQL Shared Buffers ve Linux Page Cache birbirinden farklı, ancak ilişkili önbellek mekanizmalarıdır.
İkincisi: Shared Buffers içerisinde bulunmayan bir veri bloğu, Linux Page Cache üzerinden fiziksel disk erişimi olmadan okunabilir.
Üçüncüsü: Daha büyük Shared Buffers değerleri her zaman daha iyi performans sağlamaz.
Dördüncüsü: PostgreSQL cache hit ratio, Linux Page Cache etkinliğini ölçmez.
Beşincisi: Doğru bellek optimizasyonu; PostgreSQL istatistikleri, Linux bellek metrikleri, gerçek depolama I/O değerleri ve uygulama gecikmeleri birlikte değerlendirilerek yapılmalıdır.
Sonuç olarak PostgreSQL bellek yönetiminde amaç, mümkün olduğunca fazla RAM'i Shared Buffers'a ayırmak değil, PostgreSQL ve işletim sistemi arasında iş yüküne uygun bir bellek dengesi kurmaktır.
Kaynaklar ve ileri okuma
- 1PostgreSQL Documentation — Resource Consumption
- 2PostgreSQL Documentation — Monitoring Statistics
- 3PostgreSQL Documentation — EXPLAIN
- 4Linux Kernel Documentation — Memory Management
- 5Linux Kernel Documentation — /proc Filesystem
Tartışma sorusu
Sizin PostgreSQL ortamınızda shared_buffers değerini artırmak her zaman olumlu sonuç verdi mi? Özellikle yüksek RAM kapasitesine sahip sistemlerde Linux Page Cache ile ilgili gözlemlediğiniz performans farklılıklarını yorumlarda paylaşabilirsiniz.
Sizin PostgreSQL ortamınızda shared_buffers değerini artırmak her zaman olumlu sonuç verdi mi?
Özellikle yüksek RAM kapasitesine sahip sistemlerde Linux Page Cache, dirty writeback ve checkpoint davranışları ile ilgili gözlemlediğiniz performans farklılıklarını topluluğumuzla paylaşabilirsiniz.
PostgreSQL WAL Mimarisi, Full Page Writes ve Checkpoint Yayma Optimizasyonu
Write-Ahead Log (WAL) mimarisi, Full Page Writes (FPW), checkpoint yayma optimizasyonu ve yoğun yazma iş yüklerinde disk I/O dalgalanmalarını önleme rehberi.
PostgreSQL Autovacuum Tuning & XID Wraparound: 2 Milyar İşlem Kimliği Krizini Önleme
PostgreSQL Autovacuum iç mimarisi, 32-bit işlem kimliği (XID) yaşlanması, tuple freezing, anti-wraparound vacuum mekanizması, kapasite planlama ve kriz müdahale runbook'u.