

PostgreSQL WAL Mimarisi, Full Page Writes ve Checkpoint Yayma Optimizasyonu
Write-Ahead Log (WAL) mimarisi, Full Page Writes (FPW), checkpoint yayma optimizasyonu ve yoğun yazma iş yüklerinde disk I/O dalgalanmalarını önleme rehberi.
PostgreSQL WAL Mimarisi, Full Page Writes ve Checkpoint Yayma Optimizasyonu
Kategori: PostgreSQL → Performance Tuning → Storage & WAL Teknik seviye: Intermediate / Advanced Okuma süresi: 18–22 dakika Yayın Serisi: DBA Guide | PostgreSQL Internals & Performance Tuning | İleri Seviye Teknik Makale
PostgreSQL performansını değerlendirirken genellikle sorgu optimizasyonu, indeks tasarımı, bellek yönetimi ve disk I/O üzerinde durulur. Ancak özellikle yoğun yazma işlemleri gerçekleştiren sistemlerde performansı doğrudan etkileyen başka bir mekanizma daha vardır: Write-Ahead Logging (WAL), Full Page Writes ve Checkpoint yönetimi arasındaki ilişki.
Bu üç mekanizma birbirinden bağımsız değildir. Checkpoint sıklığı, Full Page Writes nedeniyle oluşan WAL hacmini etkiler. WAL hacmindeki artış ise disk yazma yükünü, replikasyon trafiğini, arşivleme maliyetlerini ve recovery süreçlerini etkileyebilir.
Bu makalede PostgreSQL'in WAL mimarisini inceleyecek, Full Page Writes mekanizmasının veri bütünlüğünü nasıl koruduğunu açıklayacak ve checkpoint yayma (*checkpoint spreading*) optimizasyonunu gerçek sistemlerde nasıl uygulayabileceğimizi ele alacağız.
1. PostgreSQL WAL Mimarisi Nasıl Çalışır?
Write-Ahead Logging, PostgreSQL'in veri bütünlüğü ve crash recovery mekanizmasının temelini oluşturur.
WAL'ın temel prensibi şudur:
Bu yaklaşım sayesinde PostgreSQL, beklenmedik kapanma veya sistem çökmesi sonrasında veritabanını tutarlı bir duruma geri getirebilir.
▸1.1 WAL Yazma Akışı
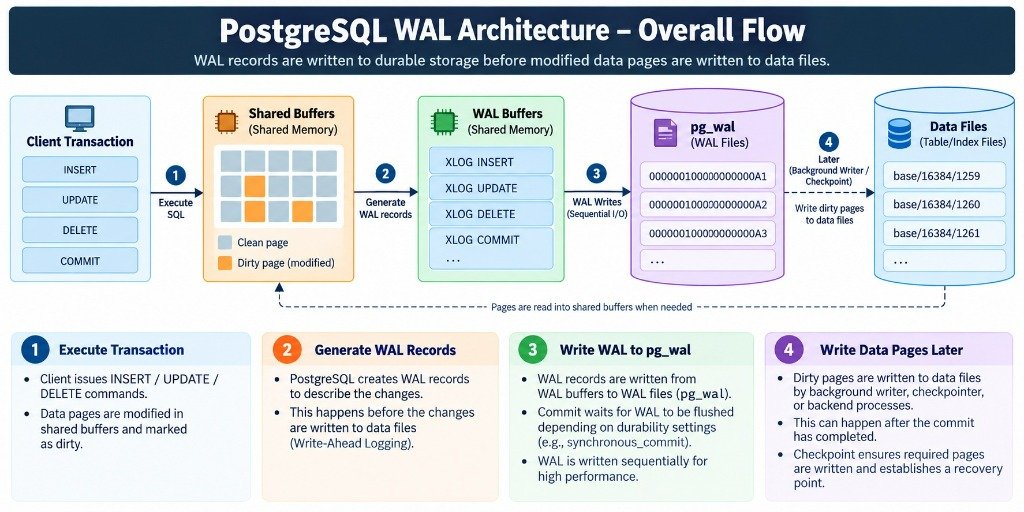
*Şekil 1 — Basitleştirilmiş WAL ve veri sayfası yazma akışı. WAL yazımı ile dirty page yazımı ayrı yollardan ilerler.*
Bir UPDATE işlemi gerçekleştiğinde PostgreSQL genel olarak şu adımları izler:
- 1İlgili veri sayfası Shared Buffers içerisinde değiştirilir ve dirty olarak işaretlenir.
- 2Değişikliği temsil eden WAL kayıtları oluşturulur.
- 3WAL kayıtları WAL buffer üzerinden WAL dosyalarına aktarılır.
- 4Commit işleminin dayanıklılık gereksinimine göre WAL uygun noktaya kadar flush edilir.
- 5Dirty veri sayfaları daha sonra background writer, checkpoint veya gerektiğinde backend süreçleri tarafından veri dosyalarına yazılır.
Buradaki önemli nokta, transaction commit işleminin normal şartlarda değiştirilmiş bütün veri sayfalarının diske yazılmasını beklememesidir.
▸1.2 WAL Dosyalarının Yapısı
WAL kayıtları, PostgreSQL veri dizini altındaki pg_wal klasöründe segmentler halinde tutulur.
Varsayılan WAL segment boyutu 16 MB'dir. Ancak cluster oluşturulurken farklı bir segment boyutu belirlenebilir.
SHOW wal_segment_size;
SHOW wal_level;
SHOW wal_buffers;
SHOW wal_compression;
WAL segmentleri yalnızca crash recovery için kullanılmaz. Ayrıca şu süreçlerin temelini oluşturur:
- •Physical streaming replication
- •Point-in-Time Recovery (PITR)
- •WAL archiving
- •Backup ve recovery
- •Logical decoding ve logical replication
Bu nedenle WAL üretim miktarındaki artış yalnızca primary sunucunun disk performansını değil, tüm PostgreSQL veri altyapısını etkileyebilir.
2. Full Page Writes (FPW) Nedir?
PostgreSQL veri sayfalarının varsayılan boyutu 8 KB'dir.
SHOW block_size;
SHOW full_page_writes;
Bir PostgreSQL veri sayfasının diske yazılması sırasında işletim sistemi, donanım veya güç kaybı nedeniyle yazma işlemi yarım kalabilir.
Bu durum torn page veya torn write olarak adlandırılır.
Örneğin 8 KB boyutundaki bir veri sayfasının yalnızca bir bölümü diske yazılmış olabilir. Böyle bir durumda veri sayfası kendi içerisinde tutarsız hale gelebilir.
Full Page Writes mekanizması bu riski azaltmak amacıyla tasarlanmıştır.
▸2.1 Full Page Writes Nasıl Çalışır?
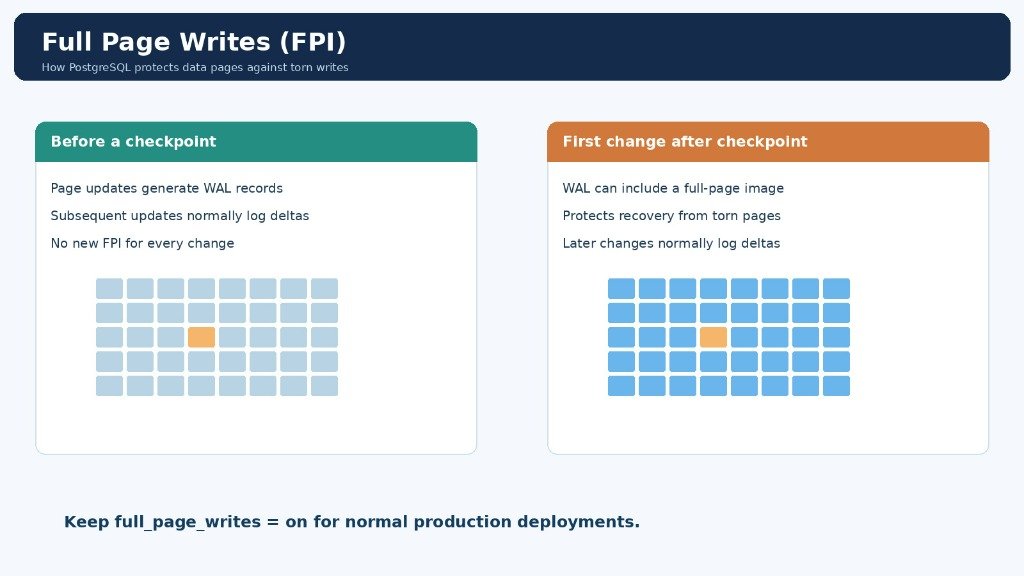
full_page_writes = on olduğunda PostgreSQL, bir checkpoint sonrasında ilgili veri sayfasının ilk değişikliğini WAL'a kaydederken sayfanın tam görüntüsünü (Full Page Image — FPI) de WAL kaydına ekleyebilir.
| Değişiklik Zamanı | WAL Kayıt İçeriği | Açıklama |
|---|---|---|
| İlk değişiklik (Checkpoint sonrası) | 8 KB Page Image (FPI)* + WAL Change Record | Sayfanın tam görüntüsü saklanır |
| Sonraki değişiklikler | Sadece WAL Change Record | Sadece delta/fark kaydedilir |
**FPI boyutu sıkıştırma, kullanılmayan alan ve WAL kayıt biçimine göre değişebilir.*
Bu mekanizmanın önemli sonuçları vardır:
- •Checkpoint sonrasında çok sayıda veri sayfasının ilk kez değiştirilmesi WAL hacmini artırabilir.
- •Aynı sayfa üzerinde sonraki değişiklikler normalde yeniden tam sayfa görüntüsü gerektirmez.
- •Yeni checkpoint döngüsüyle FPI gereksinimi yeniden oluşabilir.
Dolayısıyla checkpoint sıklığı ile Full Page Writes kaynaklı WAL hacmi arasında doğrudan bir ilişki vardır.
▸2.2 Full Page Writes Kapatılmalı mı?
Performans iyileştirmek amacıyla aşağıdaki ayarın kullanılması cazip görünebilir:
full_page_writes = offAncak üretim sistemlerinde bu ayarın kapatılması genel olarak önerilmez.
Çünkü Full Page Writes, torn page kaynaklı veri bozulmalarına karşı temel koruma mekanizmalarından biridir. WAL hacmini azaltmak uğruna crash recovery güvenilirliğini riske atmak doğru bir optimizasyon yaklaşımı değildir.
full_page_writes = on ayarını koruyun. WAL hacmini azaltmak için öncelikle checkpoint sıklığını, WAL compression kullanımını ve uygulamanın yazma davranışını değerlendirin.3. Checkpoint Mekanizması
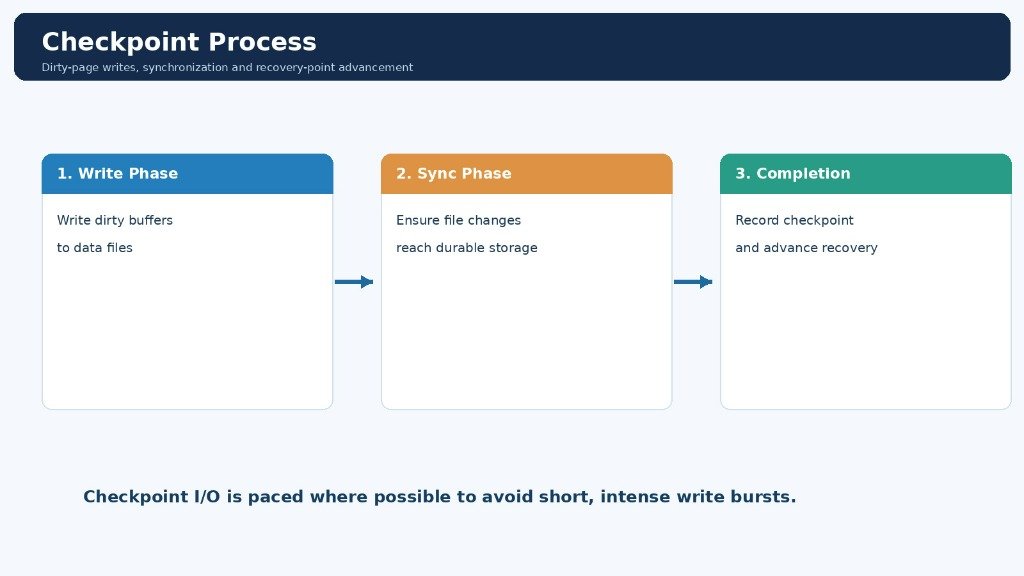
Checkpoint, PostgreSQL'in crash recovery için kullandığı önemli bir senkronizasyon noktasıdır.
Checkpoint sırasında ilgili dirty veri sayfalarının diske yazılması ve gerekli kalıcılık işlemlerinin tamamlanması sağlanır. Böylece olası bir crash sonrasında recovery işleminin başlaması gereken nokta ileri taşınabilir.
▸3.1 Checkpoint Neden Gereklidir?
Checkpoint mekanizması olmadan PostgreSQL, crash recovery sırasında çok daha eski WAL kayıtlarını işlemek zorunda kalabilir.
Checkpoint sayesinde:
- •Crash recovery süresi kontrol altında tutulabilir.
- •WAL geri kazanım başlangıç noktası ilerletilir.
- •Dirty buffer yazımları yönetilebilir.
- •WAL dosyalarının geri dönüşümü ve kaldırılması için gerekli koşulların oluşmasına katkı sağlanır.
Ancak checkpoint işlemleri disk I/O üzerinde önemli bir yük oluşturabilir.
▸3.2 Checkpoint Ne Zaman Tetiklenir?
PostgreSQL'de checkpoint işlemleri başlıca iki nedenle gerçekleşir:
| Checkpoint türü | Tetikleyici |
|---|---|
| Time-based (Zaman tabanlı) | checkpoint_timeout süresinin dolması |
| WAL-based (WAL tabanlı) | WAL hacminin max_wal_size kaynaklı checkpoint eşiğine ulaşması |
Ayrıca manuel CHECKPOINT komutu veya belirli yönetim işlemleri de checkpoint oluşturabilir.
Önemli parametreler:
SHOW checkpoint_timeout;
SHOW checkpoint_completion_target;
SHOW max_wal_size;
SHOW min_wal_size;
Yaygın varsayılan değerler:
| Parametre | Varsayılan |
|---|---|
checkpoint_timeout | 5min |
checkpoint_completion_target | 0.9 |
max_wal_size | 1GB |
min_wal_size | 80MB |
full_page_writes | on |
*Not: Değerler PostgreSQL sürümüne, dağıtıma ve yönetilen servis yapılandırmasına göre değişebilir. Üretim ortamında SHOW çıktısını esas alın.*
4. Checkpoint Spreading Nedir?
Checkpoint işlemleri sırasında çok sayıda dirty page'in kısa sürede diske yazılması disk üzerinde ani I/O yükleri oluşturabilir.
Bu durum özellikle yoğun OLTP sistemlerinde:
- •Transaction latency artışı
- •Disk write latency yükselmesi
- •I/O queue birikmesi
- •Backend write faaliyetinin artması
- •Performans dalgalanmaları
gibi sorunlara neden olabilir.
Checkpoint spreading, checkpoint yazma faaliyetinin zamana yayılmasını hedefler.
Bu mekanizma ağırlıklı olarak checkpoint_completion_target parametresiyle yönetilir.
▸4.1 Checkpoint Completion Target
Örneğin:
checkpoint_timeout = '15min'
checkpoint_completion_target = 0.9
Bu yapılandırmada PostgreSQL, zaman tabanlı checkpoint aralığının yaklaşık %90'ına yayılacak şekilde checkpoint yazma faaliyetini planlamaya çalışır.
Bu, checkpoint işleminin tam olarak 13.5 dakika süreceği anlamına gelmez. Gerçek süre I/O kapasitesine, dirty buffer miktarına ve WAL üretim hızına bağlıdır.
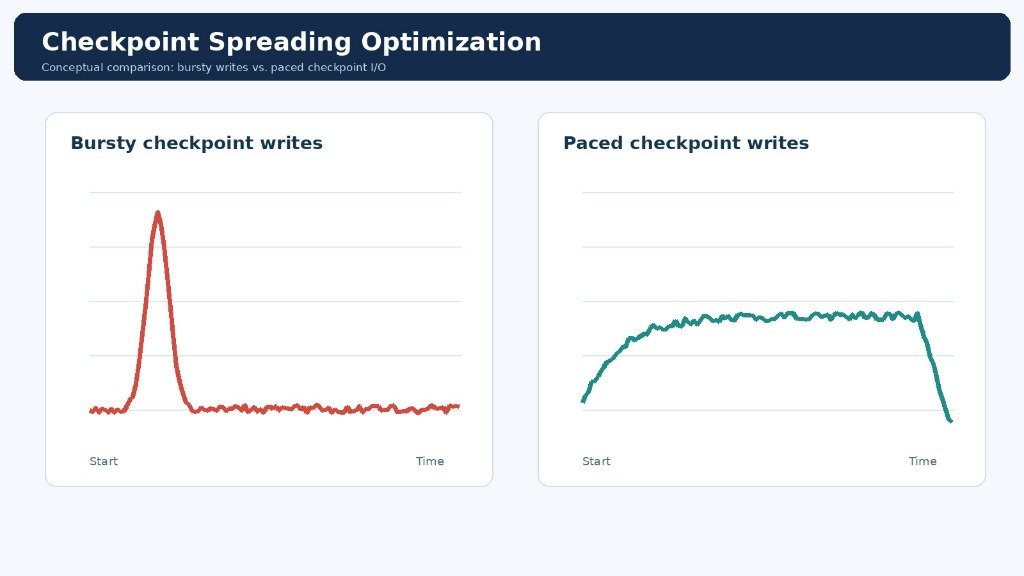
*Şekil 2 — Aynı toplam yazma yükünün kısa süreye sıkışması ile zamana yayılması arasındaki kavramsal fark. Gerçek checkpoint I/O profili farklı olabilir.*
Checkpoint yazmalarını zamana yaymak ani disk yüklerini azaltmaya yardımcı olabilir. Bununla birlikte yüksek checkpoint_completion_target, tek başına disk darboğazlarını çözmez.
5. WAL, Full Page Writes ve Checkpoint İlişkisi
Bu üç mekanizmanın birlikte değerlendirilmesi PostgreSQL performans optimizasyonunun kritik noktalarından biridir.
Örneğin yoğun yazma yapan bir veritabanında aşağıdaki yapılandırmayı düşünelim:
checkpoint_timeout = '5min'
max_wal_size = '1GB'
full_page_writes = on
Eğer sistem sık checkpoint oluşturuyorsa, her checkpoint sonrasında değiştirilen veri sayfaları için yeniden FPI kayıtları üretilebilir.
Bu durum WAL hacmini artırabilir.
WAL hacmindeki artış ise max_wal_size kaynaklı checkpoint tetiklenmesini hızlandırabilir.
Böylece iş yüküne bağlı olarak bir geri besleme döngüsü ortaya çıkabilir:
Bu nedenle checkpoint optimizasyonu yalnızca checkpoint süresini değiştirmekten ibaret değildir.
Asıl amaç WAL üretim hızı, checkpoint frekansı, dirty buffer miktarı ve disk yazma kapasitesi arasında dengeli bir çalışma modeli oluşturmaktır.
6. WAL Compression ile Full Page Writes Optimizasyonu
PostgreSQL, Full Page Image kayıtlarının boyutunu azaltmak için WAL compression mekanizmasını destekler.
SHOW wal_compression;Örneğin:
wal_compression = onBu ayar, desteklenen varsayılan sıkıştırma yöntemini kullanır. PostgreSQL derlemesinin desteklediği sürümlerde pglz, lz4 ve zstd gibi seçenekler de bulunabilir.
WAL compression özellikle FPI kayıtlarının önemli yer tuttuğu iş yüklerinde WAL hacmini azaltabilir.
Ancak sıkıştırma işlemi CPU tüketimini artırabileceği için toplam performans etkisi ölçülmelidir.
▸6.1 WAL Compression Test Yaklaşımı
Aynı iş yükünü iki farklı yapılandırmada test edebiliriz:
| Metrik | Compression Off | Compression On |
|---|---|---|
| WAL bytes | Ölçülecek | Ölçülecek |
| FPI count | Ölçülecek | Ölçülecek |
| TPS | Ölçülecek | Ölçülecek |
| CPU usage | Ölçülecek | Ölçülecek |
| Commit latency | Ölçülecek | Ölçülecek |
Burada dikkat edilmesi gereken nokta, WAL compression'ın FPI sayısını zorunlu olarak azaltmamasıdır. Temel kazanım FPI kayıtlarının kapladığı alanın küçülmesidir.
7. PostgreSQL Üzerinde WAL ve Checkpoint Analizi
Optimizasyona başlamadan önce sistemin mevcut davranışı ölçülmelidir.
▸7.1 WAL İstatistikleri
PostgreSQL 14 ve sonraki sürümlerde pg_stat_wal görünümü kullanılabilir.
SELECT
    wal_records,
    wal_fpi,
    pg_size_pretty(wal_bytes::bigint) AS wal_size,
    wal_buffers_full,
    stats_reset
FROM pg_stat_wal;
Önemli metrikler:
- •
wal_records: Üretilen WAL kayıtlarının sayısı. - •
wal_fpi: WAL'a yazılan Full Page Image sayısı. - •
wal_bytes: Üretilen toplam WAL hacmi. - •
wal_buffers_full: WAL buffer doluluğu nedeniyle gerçekleşen WAL yazma olaylarının sayısı.
Bu sayaçlar birikimlidir. Dolayısıyla anlık değerler yerine belirli zaman aralıklarındaki farkları incelemek daha anlamlıdır.
▸7.2 Checkpoint İstatistikleri
PostgreSQL 17 ve sonraki sürümlerde:
SELECT
    num_timed,
    num_requested,
    num_done,
    write_time,
    sync_time,
    buffers_written,
    stats_reset
FROM pg_stat_checkpointer;
Burada:
- •
num_timed: Zaman tabanlı planlanan checkpoint sayısı. - •
num_requested: Talep edilen checkpoint sayısı. - •
write_time: Checkpoint yazma faaliyetinde geçen toplam süre. - •
sync_time: Checkpoint senkronizasyon işlemlerinde geçen toplam süre. - •
buffers_written: Checkpointer tarafından yazılan buffer sayısı.
PostgreSQL 16 ve önceki sürümlerde ilgili checkpoint istatistikleri pg_stat_bgwriter üzerinden takip edilir:
SELECT
    checkpoints_timed,
    checkpoints_req,
    checkpoint_write_time,
    checkpoint_sync_time,
    buffers_checkpoint
FROM pg_stat_bgwriter;
Sürümler arasında istatistiklerin konumu ve isimleri değiştiğinden izleme sorguları sürüm farkındalığına sahip olmalıdır.
▸7.3 WAL Üretim Hızını Ölçmek
Aşağıdaki sorgu, WAL LSN farkı üzerinden 60 saniyelik yaklaşık üretim hızını hesaplar:
SELECT pg_current_wal_lsn() AS start_lsn \gset
SELECT pg_sleep(60);
SELECT pg_size_pretty(
    pg_wal_lsn_diff(
        pg_current_wal_lsn(),
        :'start_lsn'::pg_lsn
    )::bigint
) AS wal_generated;
Bu örnek psql istemcisine özgü \gset komutunu kullanır. Ayrıca sonuç, seçilen örnekleme aralığındaki tüm cluster WAL üretimini yansıtır.
8. Checkpoint Optimizasyonu: Örnek Senaryo
Yoğun yazma yapan bir OLTP veritabanı düşünelim.
▸Sistem Özellikleri:
- •PostgreSQL 17
- •64 GB RAM
- •NVMe SSD
- •Yoğun INSERT ve UPDATE iş yükü
- •Physical streaming replication
- •WAL archiving aktif
Başlangıç yapılandırması:
checkpoint_timeout = '5min'
checkpoint_completion_target = 0.9
max_wal_size = '1GB'
full_page_writes = on
wal_compression = off
İzleme sonucunda aşağıdaki bulguların elde edildiğini varsayalım:
- •Sık requested checkpoint
- •Yüksek WAL FPI üretimi
- •Checkpoint dönemlerinde disk latency artışı
- •Replikasyon hattında WAL transfer yükünün yükselmesi
Bu durumda ilk değerlendirme, max_wal_size değerinin iş yükü için düşük olabileceği yönünde olacaktır.
▸8.1 Örnek İyileştirme Yapılandırması
Kontrollü test ortamında aşağıdaki ayarlar denenebilir:
checkpoint_timeout = '15min'
checkpoint_completion_target = 0.9
max_wal_size = '8GB'
min_wal_size = '2GB'
full_page_writes = on
wal_compression = on
Bu değerler genel geçer optimum ayarlar değildir; yalnızca örnek bir test profilidir.
Olası kazanımlar:
- •WAL boyutu kaynaklı checkpoint sıklığının azalması.
- •FPI üretiminde azalma potansiyeli.
- •WAL compression sayesinde daha düşük WAL hacmi.
- •Checkpoint I/O yükünün daha dengeli dağıtılması.
Ancak bazı maliyetler de oluşabilir:
- •Crash recovery sırasında daha fazla WAL işlenmesi gerekebilir.
- •WAL depolama alanı gereksinimi artabilir.
- •Sıkıştırma CPU tüketimini artırabilir.
- •Replikasyon slotları veya arşivleme gecikmeleri nedeniyle WAL disk kullanımı beklenenden fazla olabilir.
Bu nedenle değişiklikler üretime alınmadan önce kapasite ve recovery hedefleriyle birlikte değerlendirilmelidir.
9. Pratik Optimizasyon Hesaplayıcısı
Aşağıdaki hesaplayıcı mantığı, WAL üretim hızına göre belirli bir zaman aralığında üretilecek WAL miktarını tahmin eder. max_wal_size için başlangıç kapasite planlamasında yardımcı olabilir.
| Parametre | Örnek Değer | Açıklama |
|---|---|---|
| Tahmini WAL Üretim Hızı | 20 MB/sn | Normal yazma trafiğinde |
| Hedef Checkpoint Aralığı | 15 dakika | checkpoint_timeout |
| Tahmini WAL Üretimi (Döngü Başına) | 17.6 GB | 15 dk × 60 sn × 20 MB/sn |
| Saatlik WAL Üretimi | 70.3 GB | 3600 sn × 20 MB/sn |
*Bu hesaplama sabit WAL üretim hızı varsayar. Checkpoint tetikleme mantığı, WAL recycling, replication slots ve archiving nedeniyle gerçek pg_wal disk kullanımı ve checkpoint sıklığı farklı olabilir.*
10. Üretim Sistemleri İçin Optimizasyon Kontrol Listesi
- PostgreSQL sürümünü ve mevcut WAL ayarlarını doğrula
pg_stat_walsayaçlarını zaman aralıklarında ölç- Requested checkpoint oranını değerlendir
- Disk write latency ve I/O kapasitesini analiz et
- Full Page Writes korumasını açık tut
- WAL compression etkisini test et
max_wal_sizevecheckpoint_timeoutdeğerlerini birlikte değerlendir- Replikasyon gecikmesi ve arşivleme durumunu kontrol et
- Crash recovery süresi ve disk kapasitesi etkisini ölç
- Değişiklik sonrası TPS, latency ve WAL hacmini karşılaştır
11. Sık Yapılan Hatalar
▸Hata 1 — WAL hacmini azaltmak için Full Page Writes kapatmak
Bu yaklaşım veri bütünlüğü açısından ciddi riskler oluşturabilir. WAL compression ve checkpoint optimizasyonu daha güvenli başlangıç noktalarıdır.
▸Hata 2 — max_wal_size değerini rastgele artırmak
Daha yüksek max_wal_size, WAL kaynaklı checkpoint sıklığını azaltabilir. Ancak recovery süresi ve depolama kapasitesi üzerindeki etkileri de değerlendirilmelidir.
▸Hata 3 — Checkpoint sayısını tek başına performans göstergesi kabul etmek
Checkpoint sayısı önemli olsa da tek başına yeterli değildir. WAL üretim hızı, FPI oranı, write latency, sync time ve transaction latency birlikte incelenmelidir.
▸Hata 4 — WAL compression'ın her durumda performansı artıracağını düşünmek
Sıkıştırma WAL hacmini azaltabilir ancak CPU maliyeti oluşturur. Kazanç iş yüküne ve kullanılan algoritmaya bağlıdır.
▸Hata 5 — max_wal_size değerini kesin disk sınırı sanmak
max_wal_size katı bir disk kotası değildir. Replikasyon slotları, WAL archiving ve diğer gereksinimler nedeniyle pg_wal dizini bu değerin üzerine çıkabilir.
12. Sonuç
PostgreSQL'de WAL, Full Page Writes ve Checkpoint mekanizmaları birlikte çalışarak hem veri bütünlüğünü hem de sistem performansını etkiler.
WAL, değişikliklerin kurtarılabilir olmasını sağlar. Full Page Writes, kısmi sayfa yazımı kaynaklı bozulmalara karşı koruma sunar. Checkpoint ise dirty veri sayfalarının kalıcı depolamaya aktarılmasını ve recovery sürecinin yönetilmesini sağlar.
Ancak bu mekanizmaların yanlış yapılandırılması gereksiz WAL üretimine, ani disk I/O yüklerine ve transaction latency dalgalanmalarına neden olabilir.
Başarılı bir PostgreSQL optimizasyonunun hedefi yalnızca WAL hacmini azaltmak veya checkpoint sayısını düşürmek değildir.
Hedef; veri güvenilirliğini korurken WAL üretimini, checkpoint frekansını, disk I/O davranışını ve recovery maliyetini dengeli biçimde yönetmektir.
Kaynaklar ve İleri Okuma
Makalenin teknik ayrıntılarını doğrulamak ve PostgreSQL sürümlerindeki farklılıkları incelemek için resmi dokümantasyon:
Sizin PostgreSQL ortamınızda shared_buffers değerini artırmak her zaman olumlu sonuç verdi mi?
Özellikle yüksek RAM kapasitesine sahip sistemlerde Linux Page Cache, dirty writeback ve checkpoint davranışları ile ilgili gözlemlediğiniz performans farklılıklarını topluluğumuzla paylaşabilirsiniz.
PostgreSQL Shared Buffers ve Linux Page Cache Etkileşimi: Bellek Yönetiminin Görünmeyen Katmanı
PostgreSQL Shared Buffers ve Linux Page Cache etkileşimi, buffered I/O yolu, double caching mekanizması, cache hit ratio yanılgısı ve bellek optimizasyonu rehberi.
PostgreSQL Autovacuum Tuning & XID Wraparound: 2 Milyar İşlem Kimliği Krizini Önleme
PostgreSQL Autovacuum iç mimarisi, 32-bit işlem kimliği (XID) yaşlanması, tuple freezing, anti-wraparound vacuum mekanizması, kapasite planlama ve kriz müdahale runbook'u.